AI 万圣节服装生成器:购买前在自己的照片上预览服装效果
使用 AI 万圣节服装生成器,在购买或缝制前用自己的自拍预览服装效果。了解提示词、拍照技巧、常见错误和短视频步骤。
要点
- 了解 AI 服装预览能展示什么、不能展示什么
- 学习一套自拍流程,让脸部和体型保持可信
- 测试 2026 年万圣节的八个服装方向
- 使用保护身份和解剖结构的提示词公式
- 将静态服装预览变成简短的万圣节短片
AI 万圣节服装生成器实际能做什么
AI 万圣节服装生成器会拿你已有的照片,根据文字描述的服装重新绘制。你上传一张清晰的自拍,输入类似“带天鹅绒兜帽和银色角的哥特独角兽吉祥物”,模型会返回一张新图片,其中服装、光线和场景发生变化,而你的姿势和整体外观保持可识别。它是一个视觉规划工具,不是商店,也不是试衣间。
有用的部分是速度。不用订购三套服装再退掉两套,你可以在一个下午比较轮廓、颜色和配饰。你可以看到及地斗篷是否会吞没你的身形,金属紧身衣看起来是服装还是健身服,以及假发颜色在派对灯光下是否适合你的肤色。这能省钱,并减少衣柜里未穿过的衣服堆积。
对限制要现实。输出是生成的图像,因此面料垂坠感、确切合身度和真实灯泡下的颜色会有所不同。搭扣、蕾丝图案和标志位置等小细节可能在多次生成之间漂移。把每次预览当作强有力的情绪板,而不是真实存在服装的照片。Flash Omni 位于 flashomni.org,是一个独立的托管 AI 图像编辑器和视频生成器,结果因模型和你提供的照片而异。
- 改变服装、造型和场景,同时保持你的姿势可读
- 帮助在花钱前比较轮廓、颜色和配饰重量
- 无法确认真实面料、尺码或精确颜色匹配
- 最适合一张清晰、光线均匀、正面朝向的自拍
如何用一张自拍获得可信的服装预览
从一张脸部清晰、无遮挡、光线均匀的照片开始。避免重度美颜滤镜、太阳镜、帽子和眼睛上的强烈阴影。纯色背景有助于模型将你与场景分开。如果你计划全身服装,第二张展示你从头到膝盖身形的照片比仅紧头部特写能更好地体现比例。
分层描述服装:先轮廓,再材料,再颜色,再配饰,再场景。类似“结构化及地外套,哑光羊毛配缎面翻领,深李子色配银色饰边,领口新月胸针,月光花园背景”给模型清晰的优先级顺序。模糊的提示词如“恐怖服装”会让太多决定听天由命,产生通用结果。
在判断前生成多个变体。一次只改变一个变量,例如斗篷长度或兜帽形状,以便公平比较。在多次运行中保持脸部和身体指令相同。如果结果看起来不对,调整照片或措辞,而不是添加越来越多的形容词,因为冗长杂乱的提示词常常模糊你最关心的细节。
- 使用清晰、正面朝向、光线均匀且无滤镜的自拍
- 如果服装覆盖身体,添加一张更广的镜头
- 描述轮廓、材料、颜色、配饰,然后场景
- 每次运行只改变一个变量以诚实比较
2026 年值得测试的八个服装方向
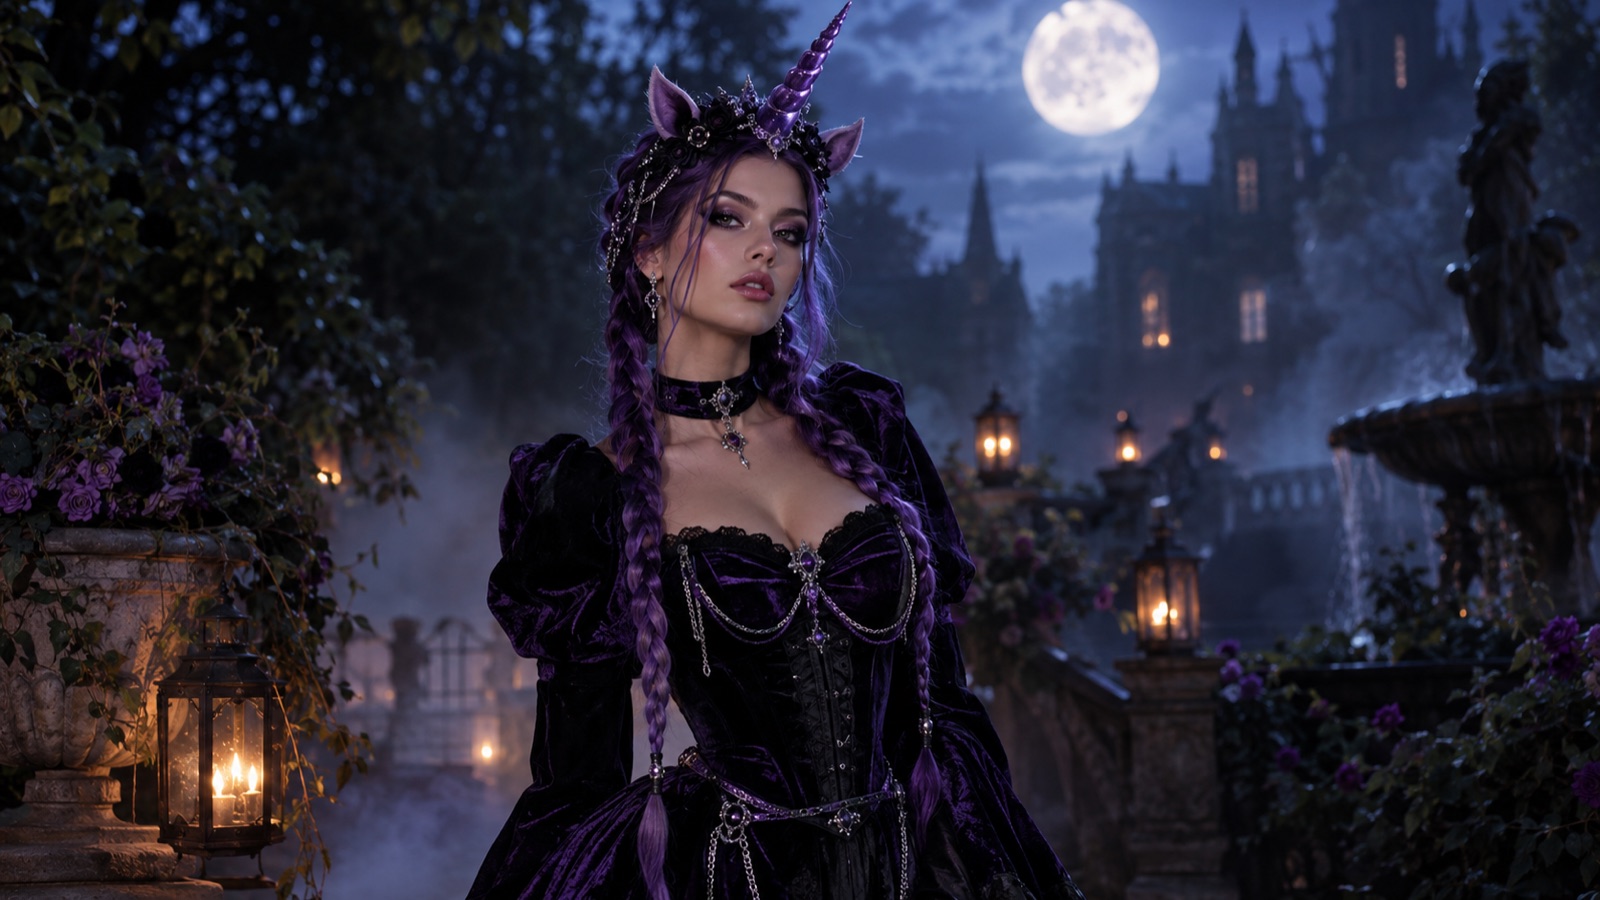
哥特独角兽吉祥物适合想要既俏皮又诡异的人:毛绒兜帽配银色角,层叠黑色薄纱,丝带系带,也许接缝处有柔和光芒。带有发光细节的宇宙公主适合情侣和团体主题,使用深海军蓝面料、星座刺绣和裙摆处微妙的灯带。仍然看起来可穿的电影感机器人服装是对克制力的良好测试,因为目标是你能实际用泡沫和面料构建的面板和关节。
对于父母来说,温和的方向往往拍照更好:苔藓纹理的林地女巫、层叠纱布的友好幽灵,或带柔软三角帽的故事书海盗。角色扮演粉丝可能更喜欢更锐利的参考,如霓虹赛博武士、裹布沙漠流浪者,或带华丽半面具的假面舞会人物。每个方向测试不同技能:纹理、光线、结构或轮廓。
选择两个方向,而不是八个。每个生成三个变体,然后筛选出你真正愿意穿四个小时的。舒适度比图像显示的更重要,所以注意服装可能限制活动、积聚热量或使坐下困难的地方。预览帮助你在承诺缝制或购买前问这些问题。
- 带毛绒兜帽和银色角的哥特独角兽吉祥物
- 带星座刺绣和发光裙摆的宇宙公主
- 由面板和关节构建的可穿电影感机器人
- 适合家庭主题的林地女巫、友好幽灵或故事书海盗
- 适合角色扮演粉丝的霓虹赛博武士或假面舞会人物
保护身份和解剖结构的提示词公式
一个可靠的公式是:保持与上传照片相同的脸、面部特征、肤色、发际线和体型,然后描述服装,然后姿势,然后光线,然后背景,然后技术说明。将身份指令放在首位赋予其权重。在结尾重复一次,措辞为“保留原始脸部和比例”,有助于那些倾向于通用脸的模型。
解剖结构也需要明确指导。要求自然的手,五根手指,真实的肢体比例,以及与原始照片匹配的姿势。如果你的自拍显示手臂放在身体两侧,就说明这一点,因为要求戏剧性抬臂姿势的提示词会招致扭曲的肩膀和手。保持相机角度与源图像一致以减少变形。
最后,将服装与场景分开。如果背景在多次运行之间变化剧烈,用简短短语如“纯深色工作室背景”固定它,并单独判断服装。一旦你喜欢这套服装,生成第二个版本,加入你想要的派对场景。这种两步法较慢,但比一次性要求所有内容可控得多。
- 以身份开头:相同的脸、特征、肤色、发际线、体型
- 明确说明姿势并与源照片匹配
- 要求自然的手和真实的比例
- 先锁定背景,然后在第二遍添加场景
拍照技巧:光线、角度、头发和服装
光线决定预览看起来像人还是人体模型。面对窗户或柔和的灯,让光线均匀落在脸上,避免明亮的窗户直接在你身后。强烈的顶光会在眼睛下方产生阴影,许多模型会忠实再现,使结果看起来疲惫。没有色偏的中性室内光是最安全的起点。
角度和光线一样重要。相机在眼睛水平线附近直拍能保持比例自然。从下往上拍会拉长身体并放大下巴,从上往下拍会缩小肩膀。保持手机稳定,避免将广角镜头靠近脸部,因为它们会扭曲鼻子和额头,模型会复制这些扭曲。
头发和服装需要思考。如果你想测试假发或兜帽,把头发扎起来;如果发型是服装的一部分,就让它松散。穿中性颜色的纯色合身衣服,以便模型干净地替换。繁忙的印花、笨重的毛衣和厚重的珠宝会混淆重绘,并经常作为奇怪的伪影保留在生成的服装中。
- 面对窗户或柔和的灯,绝不要背对明亮背景
- 在眼睛水平线拍摄,手机稳定,使用普通镜头
- 测试假发和兜帽时扎起头发,发型主导的造型则让头发松散
- 穿纯色合身衣服,以便服装能干净地替换
让 AI 服装照片看起来假的常见错误
最常见的错误是提示词过载。一句话中十个配饰、三种照明风格和两个艺术参考会产生模糊的图像,什么都读不清楚。另一个是忽略源照片:如果你的自拍模糊或一半在阴影中,没有提示词能挽救脸部。第三个是接受第一个结果,这通常是模型能产生的最通用的结果。
注意手、耳朵和肩膀的解剖结构漂移,以及服装细节相互融化,例如蕾丝变成噪点或金属饰边变成污迹。检查服装是否合理地穿在身体上,腰线位置正确,袖子在手腕附近结束。如果裙摆漂浮或领子与脖子融合,重新生成,而不是试图用更多文字修复。
风格不匹配更微妙。逼真的脸配绘画背景看起来像拼贴画。尽早决定你想要编辑照片、电影剧照还是插画概念,并保持光线和纹理与该选择一致。一致性,而不是复杂性,才是让服装预览令人信服的原因。
- 不要在一个提示词中堆叠太多配饰或照明风格
- 绝不要从模糊或光线不佳的自拍开始
- 检查手、腰线、袖长和裙摆位置
- 在整个图像中保持一种视觉风格
从服装预览到五秒万圣节视频
一旦静态预览看起来正确,短片可以展示服装如何移动。Flash Omni 支持图像转视频,因此你可以动画化已批准的图像,而不是从文本重新开始。五秒的片段足以展示斗篷移动、裙摆发光脉冲或头部缓慢转动。保持运动指令简单且物理化。
描述一个动作和一个相机行为。例如:缓慢推近,面料轻轻摆动,裙摆处微妙发光脉冲,角色保持平静表情。避免在同一片段中要求行走、跳舞和换装,因为短生成处理一个清晰动作比序列好得多。视频运行在 Seedance 2.0 上,模型提供商和路由合作伙伴因模型而异。
将片段用于规划,而不是承诺。它帮助你看到长斗篷是戏剧性还是笨拙,以及发光细节是否能在黑暗派对中存活。它不会告诉你真实服装穿三小时后的感觉。图像和视频任务的积分在确认前显示,一次性公开包 500 积分起价 19.99 美元,月度计划 500 积分起价 14.99 美元。
- 动画化已批准的静态图,而不是从文本重新开始
- 每个片段要求一个动作和一个相机行为
- 使用片段判断运动中的戏剧性、发光和轮廓
- 在确认每个任务前检查积分成本
隐私、同意和负责任的使用
只上传你有权使用的照片。对于情侣或家庭预览,在上传前获得画面中每个人的同意,包括儿童,并考虑裁剪为一次一个人。不要上传朋友、同事或公众人物的图像来测试服装。保持原始文件私密,并在工具允许的情况下删除不再需要的上传。
对图像是什么要诚实。生成的服装预览是概念,不是真实服装的证据,将其呈现为你穿过的某物的照片可能会误导人们。如果你在社交媒体上分享,标记为 AI 预览。避免使用生成的图像暗示背书、销售不存在的产品或描绘任何人会反对的方式。
预期限制并公平对待它们。Flash Omni 不承诺精确肖像、商业权利或退款,结果取决于照片、模型和提示词。在任何商业使用前阅读条款。负责任的使用很简单:你自己的照片、明确的同意、诚实的说明和对预览能告诉你什么的现实期望。
- 只上传你自己的照片或你有权使用的图像
- 获得每个可见者的同意,尤其是儿童
- 将分享的图像标记为 AI 预览
- 不要假设商业权利或精确肖像
继续探索
提示词配方
提示词配方保留英文,因为图片和视频模型对英文指令的遵循最稳定;指南正文已本地化。
可穿的电影感机器人服装
Redraw the uploaded selfie as a cinematic but believable robot costume portrait. Preserve the same face, facial features, skin tone, hairline and body shape, and keep the original camera angle and pose. Costume: wearable robot suit built from matte grey foam panels, visible fabric joints at the elbows and knees, a rounded chest plate with a small amber indicator light, and a half helmet that leaves the face fully visible. Materials should look handmade and practical, not CGI. Lighting: cool industrial side light with warm amber accents, plain concrete backdrop, shallow depth of field, natural hands, realistic proportions, photorealistic, no text, no watermark.
常见问题
AI 万圣节服装生成器能准确显示服装的合身程度吗?
不能。它显示轮廓、颜色、造型和氛围,而不是真实合身度。面料垂坠感、尺码以及服装穿几小时后的感觉无法从生成的图像预测。使用预览筛选想法,然后在购买或裁剪面料前检查真实尺寸、退货政策和材料描述。
服装预览需要全身照片吗?
清晰的头像适用于面具、兜帽、化妆和上半身服装。对于礼服、斗篷和全套西装,添加第二张展示你从头到膝盖身形的照片。保持两张照片光线均匀且无滤镜,并描述你想要的姿势,以免模型发明不自然的站姿。
为什么我的脸在多次生成之间会变化?
当提示词模糊、源照片柔和或有阴影,或模型优先考虑服装细节而非脸部时,身份漂移就会发生。将身份指令放在首位,在结尾重复,保持姿势接近原始,并一次改变一个变量,以便你看到是什么导致了漂移。
生成服装预览需要多少费用?
Flash Omni 在确认每个图像或视频任务前显示积分成本。一次性公开积分包 500 积分起价 19.99 美元,月度计划 500 积分起价 14.99 美元。成本因模型和工作流程而异,因此请检查确认屏幕,而不是假设每张图像的固定价格。
我可以将服装预览变成视频吗?
可以。对已批准的静态图使用图像转视频,并描述一个简单动作,例如面料摆动或发光脉冲,加上一个相机行为。视频运行在 Seedance 2.0 上。短片段最适合单一动作,模型提供商和路由合作伙伴因模型而异。
上传我家人的照片安全吗?
只上传你有权使用的照片,并获得每个可见者的同意,包括儿童。尽可能裁剪为一个人,保持文件私密,并将任何分享的结果标记为 AI 预览。避免上传未经同意者的图像。
本指南由 Flash Omni 编辑团队维护。产品限制、模型可用性和价格可能变化,购买积分前请以工作台当前显示为准。
相关指南
AI 万圣节视频生成器:将一张静态图片变成电影感五秒短片
将一张万圣节静态图片变成五秒电影感短片,适用于 TikTok、Reels 和 Shorts。学习镜头运动、稳定面部、声音和可重复的工作流程。
阅读指南